ITトレンド記事 コラム
止められない業務を支える「無停止サーバー」
高可用性を実現する仕組みと選び方
WirelessWire & Schrödinger's 編集長 岩元 直久 氏
ITの停止が、生産、物流、医療など現実の業務停止に直結するようになり、情報システムはこれまで以上に高い可用性が求められています。しかし、あらゆるシステムを絶対に止めないということは現実的ではなく、可用性を高めるほどコストや運用負荷も増します。重要なのは、業務への影響を把握し、復旧目標を定めた上で、必要な対策を選ぶことです。無停止サーバーをはじめとする可用性対策の特徴と、業務継続を支えるシステム設計の考え方を解説します。
IT停止が業務停止に直結する時代
ITは私たちの暮らしを支える力強い存在です。プライベートでの情報のやり取りやコード決済などはもちろん、ビジネスでも、オフィスのさまざまな情報処理から、工場の生産管理や製造実行、設備監視、検査、物流倉庫の搬送や入出荷、医療機関の電子カルテや検査など、ありとあらゆるところでITが活躍しています。
これだけITが生活やビジネスに入り込むようになると、情報システムは社会インフラとしての側面を持つようになります。工場や物流の情報システムが止まると、製品の製造ができなくなったり、必要な品物が手に入らなくなったりします。医療機関での情報システムの停止は、医療行為を行う上で様々な危険と隣り合わせでもあります。
同時にITは24時間365日稼働が求められるようになっています。グローバル化や24時間対応の必要性が高まった現在では、情報システムを止められる時間が短くなっています。さらに、多くの企業が連携して業務を遂行するようになった今は、1つの情報システムのトラブルがサプライチェーン全体に影響を及ぼす可能性もあります。
内閣府の「令和8年版 防災白書」では、大規模災害などによって企業の事業活動が停滞した場合、その影響は自社にとどまらず、サプライチェーンの途絶を通じて、取引先や地域経済、日本全体にも拡大するリスクを指摘しています。また事業継続計画(BCP)が想定する事態として、自然災害だけでなく、感染症、テロなどの地政学リスク、サイバー攻撃なども挙げ、重要業務を中断させない、または中断しても可能な限り短時間で復旧させることの重要性を説いています。
すなわち、「止められない業務」が増えたというよりも、IT停止の影響範囲が広がり、企業が許容できる停止時間が短くなったと捉える必要があります。止まりにくく、止まっても短時間で復旧できるシステムが、より一層求められているのです。
「止められない」から具体的な復旧目標に
「金融取引を止められない」「工場を止められない」「医療システムを止められない」など、止められない業務は無数にあります。しかし、「止められない」というだけでは、情報システムの設計要件にはなりません。情報システムごとに「止められない」の意味が異なるからです。例えば同じ工場でも、数秒の停止が不良品や設備損傷につながるシステムもあれば、数分間なら停止できるシステム、数時間以内に復旧すれば大きな問題が起こらないシステムもあります。一時的には手作業で代替できる業務もあるでしょう。
コストの面からも、すべての情報システムを極めて停止しにくい状態にすることは現実的ではありません。システムが継続して稼働できる能力を「可用性」といいますが、一般により高い可用性を実現するには相応のコストが必要となるためです。コストをかけて可用性を高めるシステムと、それ以外のシステムを整理する必要があります。
整理の仕方としては、(1)業務への影響を把握する、(2)許容停止時間と許容データ損失を決める、(3)復旧する業務範囲と処理能力を決める、(4)必要な可用性と対策を選ぶ――という順番で考えるとよいでしょう。その際に使える指標として、情報処理推進機構(IPA)が公開した指針「高回復力システム基盤導入ガイド(概要編)」では、「RTO」「RPO」「RLO」の3つの復旧目標を掲げています。
RTOは目標復旧時間で、停止後、どれだけの時間で業務を必要な水準まで復旧させるかを指します。RPOは目標復旧時点で、障害発生時にどの時点までのデータを復旧できればよいかを示します。最後のRLOは目標復旧レベルで、復旧時に、どの業務をどの程度の処理能力まで戻すかを表します。
工場でトラブルや災害によるシステム障害が起きた場合を考えます。一例として、RTOは「重要な生産ラインを3時間以内に再開する」、RPOは「直近のバックアップ時点に当たる、障害発生の1時間前までの生産データを復旧する」、RLOは「需要が見込まれる製品を優先し、平常時の50%の処理能力まで戻す」などと設定できます。このように3つの指標を使うことで、いつまでに、どの時点までのデータを復旧し、どの業務をどの水準まで戻すのかを具体化できます。
重要なことは、「止められるか、止められないか」の二者択一ではありません。どの業務を、どれだけの時間、どの程度まで止められるのかを事前に可視化しておくことです。業務によっては、「出荷の締めなど特定の時間帯だけは止められない」という要件もあります。情報システム側の視点だけでなく、業務部門とともに停止の影響を具体化する必要があります。
業務に応じて可用性の水準を選ぶ
業務の復旧目標を可視化したら、必要な可用性と対策を選択するステップに移ります。闇雲に高い可用性を求めるのではなく、数秒の停止も許容しにくいシステム、短時間の停止は許容できるシステムなどを整理すれば、適切な対策が選べます。
数秒の停止も許容しにくい業務を支えるには、一部の部品に障害が起きても処理を継続できるよう冗長化したフォールトトレラントシステム(Fault Tolerant System)が有力な選択肢になります。短時間の切り替えを許容できるシステムでは、稼働系と待機系を用意し、障害時に処理を引き継ぐHA(High Availability=高可用性)クラスタなどが選択肢になります。さらに長い復旧時間を許容できる業務では、待機環境やバックアップから復旧する方法も選べます。システムを利用できない間は、手作業などで代替して業務を継続する運用を残す場合もあります。
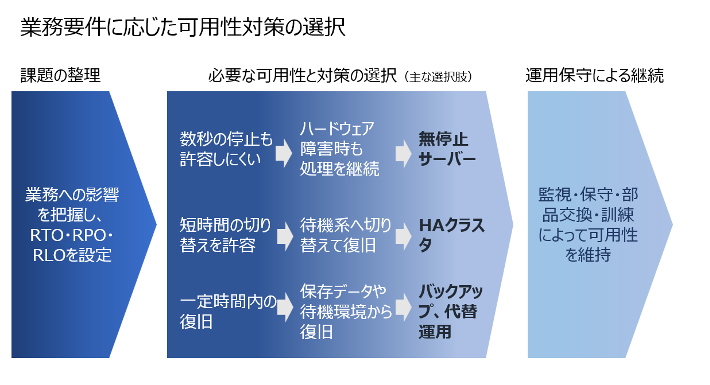
フォールトトレラントシステムは、ハードウェア障害による処理中断を抑え、高い可用性を実現する方法の1つです。一方、停止時間があっても大きな問題にならない業務であれば、より費用対効果を踏まえた構成でも効果は十分に得られます。可用性を高めれば、一般に導入コストだけでなく、設計や運用の複雑さも増します。可用性、コスト、運用負荷、人材、保守期間のバランスを考えて、可用性の対策を検討する必要があります。
無停止サーバーが提供する可用性とは
フォールトトレラントの仕組みを用いて、一部のハードウェアに障害が発生しても処理を継続できるようにしたサーバーが「無停止サーバー」です。プロセッサ、メモリー、ストレージ、電源などの主要な構成要素を冗長化し、障害が発生した側を切り離して、正常な側で処理を続けます。
無停止サーバーの導入効果が高いのは、待機系への切り替え時間を含めてごく短時間の停止も業務に大きな影響を及ぼすシステムです。その上で、ハードウェア障害に伴う処理の中断やデータ損失を抑えたい、複雑になりがちなクラスタの運用管理を避けたい、専門技術者が少ない拠点で利用したいといった条件を加味します。工場の設備監視や生産管理、物流、医療などが主に想定されますが、業種だけでなく、システムが担う業務の要件に基づいて判断するとよいでしょう。
無停止サーバーが主に対応するのは、サーバーを構成するハードウェアの障害です。アプリケーションの不具合やデータ破損、ネットワーク障害、サイバー攻撃、拠点全体の停電や災害などは、無停止サーバーだけでは防ぎきれません。ネットワークや電源の冗長化、バックアップ、災害復旧対策(DR)、セキュリティ対策などを組み合わせることで、業務システム全体の可用性を高められるのです。無停止サーバーは、業務継続全体を一台で実現するものではなく、特に短い停止も許容できない領域を支える構成要素という位置づけです。
また、冗長化された機器でも、一方の構成要素が故障した状態で放置すれば、次の障害で業務が停止する可能性があります。高い可用性は、無停止サーバーなどの機器を導入するだけでは実現できません。監視、保守、部品交換、訓練などの継続した運用で維持する必要があるからです。運用サポートを適切に提供できる、信頼できるベンダーとパートナーシップを組むことも検討したい要素です。
「絶対に止まらない」システムを作ることはできません。だからこそ、事業ごとに許容できない停止を見極め、その部分には無停止サーバーなどによる高い可用性を持たせる必要があります。万一、同時に停止した場合の復旧や代替手段などを準備し、運用・保守で可用性の実効性を維持することも重要です。事業が求める可用性は、システムと運用の両面から設計することで、初めて効果を発揮するのです。